
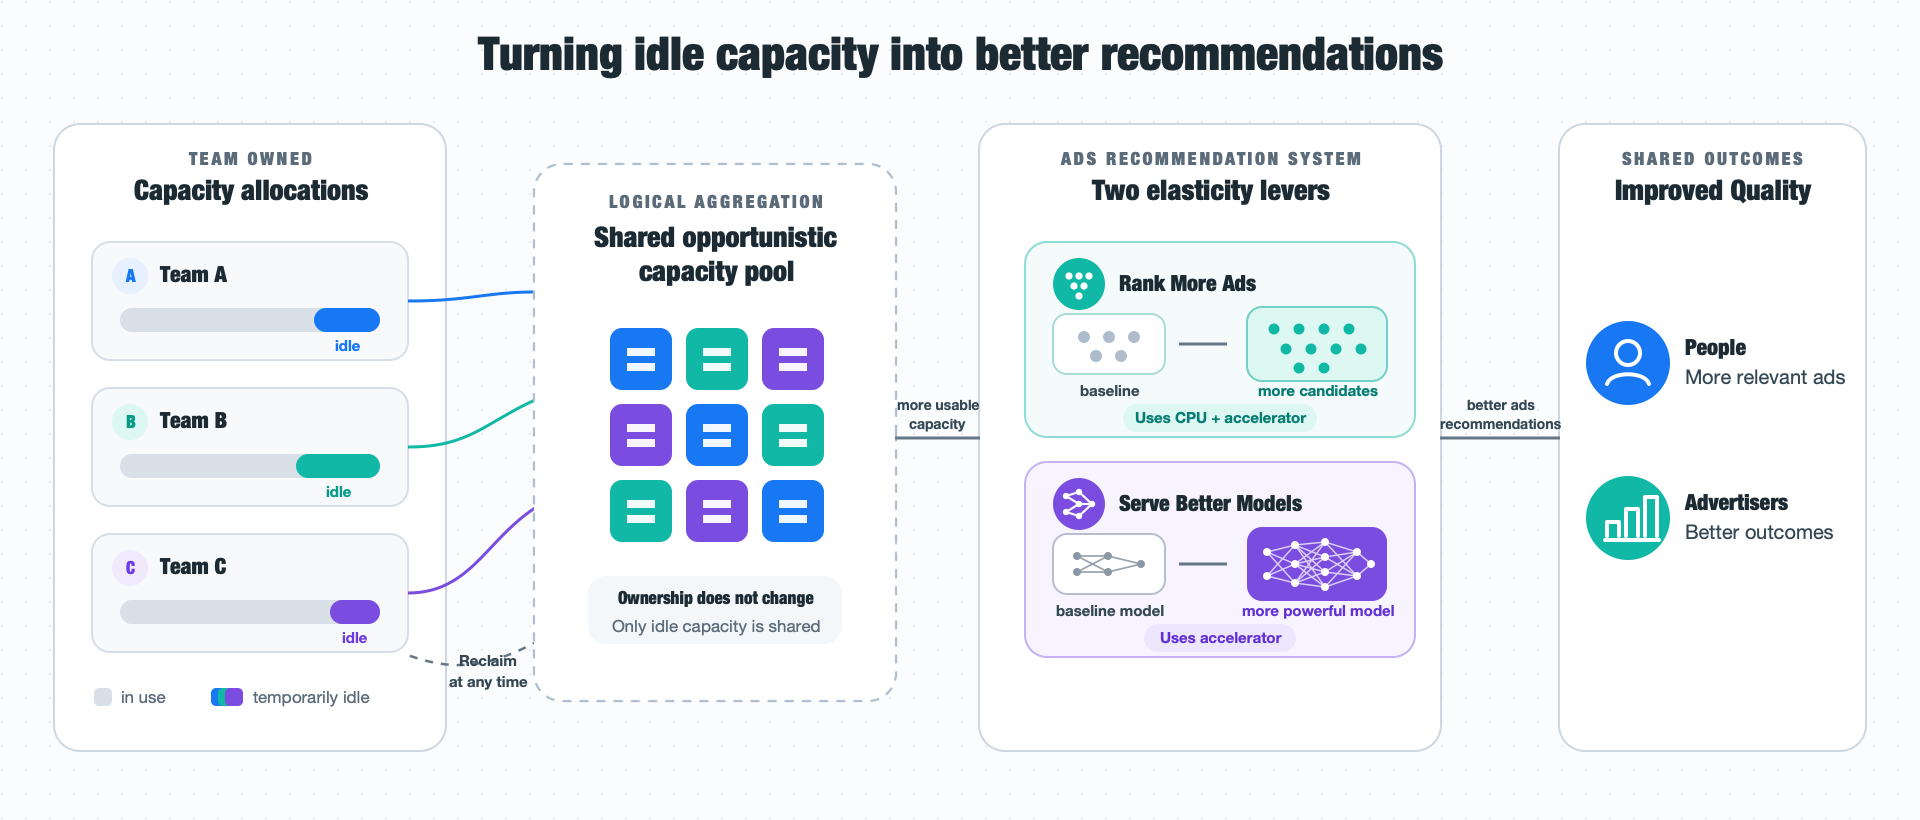
你可以把推理集群想成一家为晚高峰留足座位的餐厅:忙时满座,闲时却不能轻易撤桌。Meta想做的是,在这些座位暂时没人用时,让广告推荐多做一点计算;原来的客人一来,额外工作马上让位。它试图解决的不是“机器够不够”,而是昂贵算力明明已经部署,为什么仍有不少时间闲着。
据Meta于2026年10月12日发布的工程博客,公司已经把这套机制用于广告推荐,并称它不会损害基线性能。不过,目前公开材料只有官方摘要和相关工程介绍,没有论文或第三方评测,所有效果判断都来自Meta自述。
闲置算力,也有使用期限
模型推理(inference)是训练好的模型接收新输入、给出预测的过程。广告推荐系统会据此估计用户点击或转化某个候选广告的可能性,再完成排序。更多计算有时意味着可以评估更多候选,或运行更复杂的模型,但广告请求必须在实时响应期限内完成。
这里能借用的是“机会算力”(opportunistic capacity):为高峰或关键任务预留、此刻恰好空闲的资源。它便宜在不用新增机器,麻烦在随时可能被原任务收回。因此,系统不能只会扩张,还必须能迅速缩回去。
Meta称,其系统设置了两个“弹性调节杆”。弹性伸缩(elasticity)就是让工作负载跟着资源自动扩张或收缩。公开摘要没有说明两级机制的完整设计,但相关官方工程材料给出了核心思路:中央控制器负责较慢的整体调节,服务器端和客户端则承担毫秒级保护。
真正难的是把算力还回去
这套系统最关键的场景不是获得空闲资源,而是资源突然消失。据Engineering at Meta介绍,中央控制器可能需要几分钟才能重新调节,机会容量却可能瞬间被收回。如果所有额外推荐计算继续运行,请求就可能堆积,继而拖慢原有服务。
为此,服务器端和客户端会在几毫秒内丢弃价值较低的额外排序工作。系统可以少计算一些候选广告,或者退回基础模型,同时让正常广告请求继续完成。换句话说,它把额外计算设计成“有余力就做、没余力就放弃”的可选层,而不是让基线服务依赖这笔借来的资源。
这也解释了两级弹性的价值:慢速机制负责尽量多吃下集群余量,快速机制则在资源被抢占时及时踩刹车。前者争取推荐收益,后者守住延迟和稳定性。
它为什么值得关注?
思路本身并非凭空出现。据Software Engineering at Google和Google Research介绍,Google的Borg早已会把后台批处理任务塞进在线服务未使用的容量:当服务任务只实际使用约30%的CPU时,批任务可以利用剩余部分;在线服务需要资源时,这些任务会被冻结,争抢内存的任务甚至会被终止。
Meta这次值得看的变化,是把可牺牲工作放进了同一次广告请求:临时多排一些候选,或临时使用更强的模型。这样,闲置容量不只是帮后台任务排队,而是可能直接改善面向用户的推荐结果。
这也延续了Meta此前对“忙闲不均”的治理。据Engineering at Meta介绍,团队在2024年通过调整负载均衡和模型部署,让同一批硬件最多承受多35%的负载,超时错误减少三分之二,p99尾延迟——最慢那1%请求的响应时间——减半。此前是在同一服务内部填平峰谷;此次则进一步汇集跨团队、跨地区的临时空档。
局限与未知
- Meta没有公布广告推荐提升幅度、算力利用率、成本或延迟变化,因而无法量化“闲置算力变成了多少推荐增量”。
- “不损害基线性能”缺少基线定义、评价指标、实验范围和异常场景说明,目前只能视为官方主张。
- 公开摘要没有完整披露两个弹性调节机制的实现和运行边界,也没有独立评测可供交叉验证。