
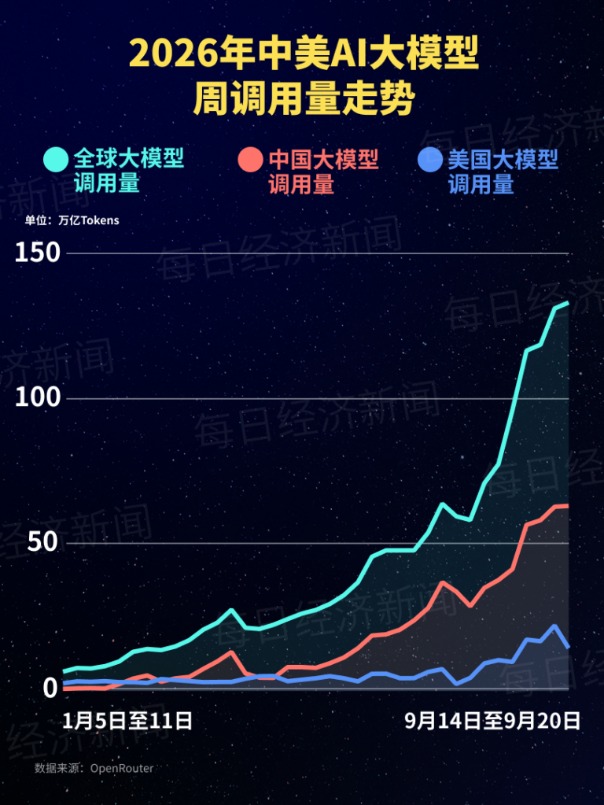
中国模型的调用热度又突然抬高了一截。据《每日经济新闻》基于OpenRouter数据测算,9月14日至20日,中国模型周调用量达到67.46万亿Token——Token是模型处理文字等信息的基本单位——相当于美国同期14.21万亿的约4.7倍,并连续21周领先。相比此前一周约2.81倍的差距,这次更像一次显著加速,而非普通榜单换位。不过,OpenRouter只是聚合多家模型API的第三方平台,其数据反映平台内任务流向,不等于全球用户数、市场份额或收入。
增量主要来自9月10日发布的DeepSeek V4.1-Flash:它以15.8万亿Token登顶,环比增长219%。Flash指为速度和低成本优化的模型档位,适合高频日常任务。该模型采用Causal Encoder-Decoder结构,把全局KV Cache——模型保存上下文中间结果的“草稿纸”——压到前代约四分之一,并下调多档价格。但便宜未必等于单项任务总成本更低:Artificial Analysis测试中,它平均每项任务输出约8.9万Token,高于前代约6.2万,输出也被评价为较冗长。